使用 Linux 的 grep 和 fgrep 命令来赢得你最喜欢的基于单词的猜测游戏。
我最近有点迷恋上了一个在线单词猜谜游戏,在这个游戏中,你有六次机会来猜一个随机的五个字母的单词。这个词每天都在变化,而且你每天只能玩一次。每次猜测后,你猜测中的每个字母都会被高亮显示:灰色表示该字母没有出现在神秘单词中,黄色表示该字母出现在单词中,但不在那个位置,绿色表示该字母出现在单词中的那个正确位置。
下面是你如何使用 Linux 命令行来帮助你玩像 Wordle 这样的猜测游戏。我用这个方法来帮助我解决 1 月 6 日的谜题:
第一次尝试
Linux 系统在
/usr/share/dict/words文件中保存了一个单词词典。这是一个很长的纯文本文件。我的系统的单词文件里有超过 479,800 个条目。该文件既包含纯文本,也包含专有名词(名字、地点等等)。为了开始我的第一次猜测,我只想得到一个长度正好是五个字母的纯文本词的列表。要做到这一点,我使用这个
grep命令:$ grep '^[a-z][a-z][a-z][a-z][a-z]$' /usr/share/dict/words > myguess
grep命令使用正则表达式来进行搜索。你可以用正则表达式做很多事情,但为了帮助我解决 Wordle 问题,我只需要基本的东西。^表示一行的开始,$表示一行的结束。在两者之间,我指定了五个[a-z]的实例,表示从 a 到 z 的任何小写字母。我还可以使用
wc命令来查看我的可能单词列表,“只有” 15,000 个单词:$ wc -l myguess 15034 myguess从这个列表中,我随机挑选了一个五个字母的单词:
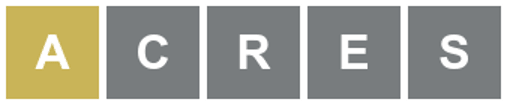
acres。a被设置为黄色,意味着该字母存在于神秘单词的某处,但不在第一位置。其他字母是灰色的,所以我知道它们并不存在于今天的单词中。
第二次尝试
对于我的下一个猜测,我想得到一个包含
a的所有单词的列表,但不是在第一位置。我的列表也不应该包括字母c、r、e或s。让我们把这个问题分解成几个步骤。为了得到所有带 a 的单词的列表,我使用
fgrep(固定字符串 grep)命令。fgrep命令也像grep一样搜索文本,但不使用正则表达式:$ fgrep a myguess > myguess2这使我的下一个猜测的可能列表从 15,000 个字下降到 6,600 个字:
$ wc -l myguess myguess2
 15034 myguess
  6634 myguess2
 21668 total
但是这个单词列表中的第一个位置也有字母
a,这是我不想要的。游戏已经表明字母a存在于其他位置。我可以用grep修改我的命令,以寻找在第一个位置包含其他字母的词。这就把我可能的猜测缩小到了 5500 个单词:$ fgrep a myguess | grep '^[b-z]' > myguess2 $ wc -l myguess myguess2 15034 myguess 5566 myguess2 20600 total但我知道这个神秘的词也不包括字母
c、r、e或s。我可以使用另一个grep命令,在搜索中省略这些字母:$ fgrep a myguess | grep '^[b-z]' | grep -v '[cres]' > myguess2 $ wc -l myguess myguess2 15034 myguess 1257 myguess2 16291 total
-v选项意味着反转搜索,所以grep将只返回不符合正则表达式[cres]或单列字母c、r、e或s的行。有了这个额外的grep命令,我把下一个猜测的范围大大缩小到只有 1200 个可能的单词,这些单词在某处有一个a,但不在第一位置,并且不包含c、r、e、或s。在查看了这个列表后,我决定尝试一下
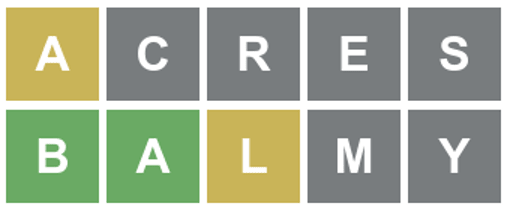
balmy这个词。
第三次尝试
这一次,字母
b和a被高亮显示为绿色,意味着我把这些字母放在了正确的位置。字母l是黄色的,所以这个字母存在于单词的其他地方,但不是在那个位置。字母m和y是灰色的,所以我可以从我的下一个猜测中排除这些。为了确定下一个可能的单词列表,我可以使用另一组
grep命令。我知道这个词以ba开头,所以我可以从这里开始搜索:$ grep '^ba' myguess2 > myguess3 $ wc -l myguess3 77 myguess3这只有 77 个词! 我可以进一步缩小范围,寻找除第三位外还包含字母
l的词:$ grep '^ba[^l]' myguess2 > myguess3 $ wc -l myguess3 61 myguess3方括号
[^l]内的^表示不是这个字母列表,即不是字母l。这使我的可能单词列表达到 61 个,并非所有的单词都包含字母l,我可以用另一个grep搜索来消除这些单词:$ grep '^ba[^l]' myguess2 | fgrep l > myguess3 $ wc -l myguess3 10 myguess3这些词中有些可能包含字母
m和y,而这些字母并不在今天的神秘词中。我可以再进行一次反转grep搜索,将它们从我的猜测列表中删除:$ grep '^ba[^l]' myguess2 | fgrep l | grep -v '[my]' > myguess3 $ wc -l myguess3 7 myguess3我的可能的单词列表现在非常短,只有七个单词!
$ cat myguess3
babul
bailo
bakal
bakli
banal
bauld
baulk
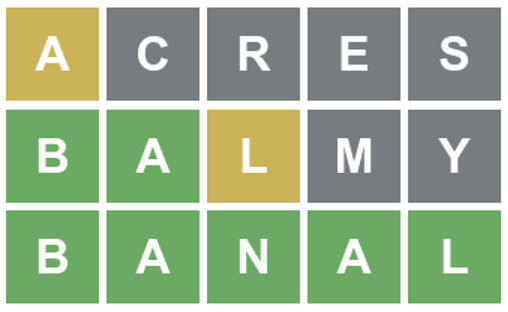
我选择
banal作为我下一次猜测的可能的词,而这恰好是正确的。
正则表达式的力量
Linux 的命令行提供了强大的工具来帮助你完成实际工作。
grep和fgrep命令在扫描单词列表方面提供了极大的灵活性。对于一个基于单词的猜测游戏,grep帮助识别了一个包含 15000 个可能的单词的列表。在猜测并知道哪些字母出现在神秘的单词中,哪些没有,grep和fgrep帮助将选项缩小到 1200 个单词,然后只剩下 7 个单词。这就是命令行的力量。