题图来自:AI生成
最近看 Jev,我最开始也被一个问题带偏了:它会不会干掉正则?
这个联想很自然。正则做的,本来就是判断一段东西“是不是某种东西”。手机号、URL、IP、日志字段,都可以靠规则匹配。Jev 也在做判断,只不过对象从字符串变成了语义:“这封邮件是不是投诉?”、“这个请求要不要人工介入?”、“这个操作是不是高风险?”
于是 Jev 很容易被理解成 semantic regex(语义正则)。这个比喻很好懂,但把 Jev 的价值看轻了。
Jev 真正值得看的,是它暴露了今天 Agent 架构里一个有点奇怪的现实:我们正在把一批本来不需要深度推理的语义判断,也默认交给完整的 reasoning model。
核心定界:答案只有 Yes / No,并不意味着问题简单
判断一段代码有没有并发漏洞,最终答案只有 Yes / No;判断一份几十页合同是否存在法律风险,输出也可以压缩成两个选项。但得到这个答案,可能需要长上下文、多步因果和反事实推演。
所以真正适合拆出来的,是一类更窄的任务:高频、局部、状态相对闭合、答案空间有限,而且不需要展开复杂推理链的语义判断。一、 一个 Agent,到底有多少计算真的需要深度推理?
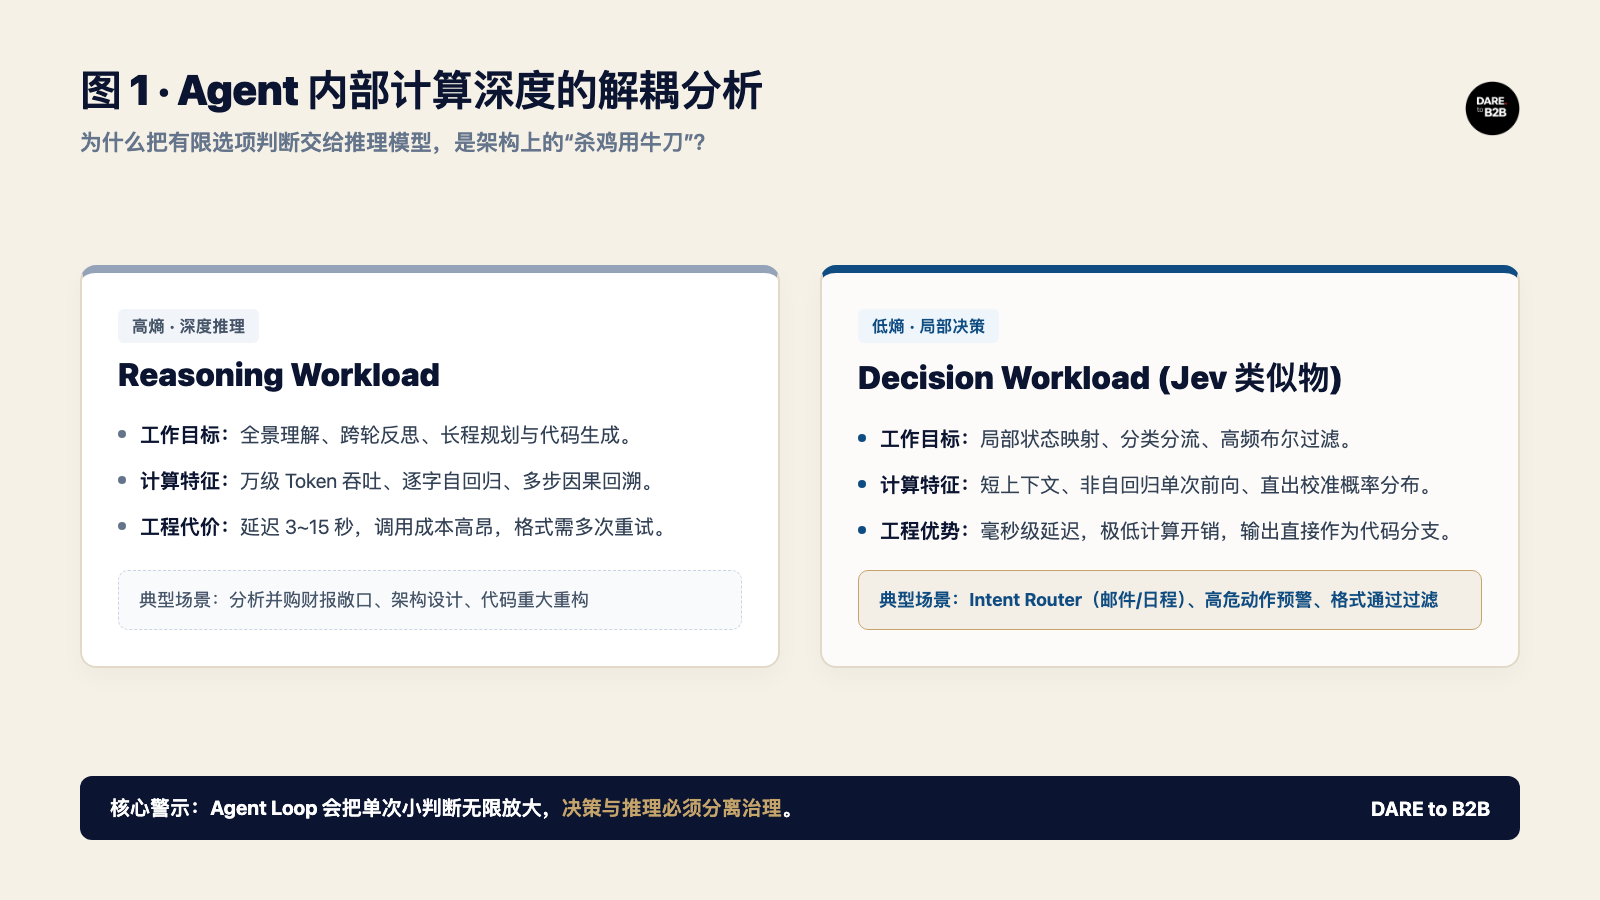
今天一个 Agent 接到任务,背后可能连续回答很多问题:用户想干什么?要不要调用工具?调用哪个工具?这次结果相关吗?这个操作是不是危险?用户授权清楚了吗?要不要继续?
这些问题当然都需要某种智能,但它们的计算深度差别很大。
让模型分析一份财报,和根据一条短请求判断“应该进入 Gmail 还是 Calendar”,不是同一类工作;让模型设计一个复杂迁移方案,和判断“当前动作是否属于文件删除”,也不是同一类工作。
可很多 Agent 架构今天采用的是同一种默认路径:模型读上下文,开始生成,输出一个结构化结果;应用解析结果,格式不对可能重试,最后只是为了得到 { "tool": "gmail" }。
偶尔做一次没有什么。问题出在 Agent 有 loop——这种小判断会不断夹在规划、工具调用和状态变化之间。所以真正应该算的账是:整个 Agent loop 里,有多少计算真的需要推理,又有多少只是局部状态到有限动作空间的映射?
Jev 切的就是后一类。TypeSafe 把 Jev 定义成一种 System One Model:输入非结构化状态,输出预先定义的 typed probabilistic decisions,而不是逐 token 生成自然语言。官方公开材料强调,它会并行产生这些判断,而不是像普通生成模型一样顺序生成字符串。这至少提出了一个值得讨论的问题:语义判断,是否应该始终和自然语言生成绑定在一起?
图 1 · Agent 内部计算深度的解耦:高熵推理 vs 低熵局部决策
二、 这本账,不只是 Token
TypeSafe 给 Jev 公布过非常漂亮的延迟和成本数字。但现在不能把这些数字直接当成行业事实。
TypeSafe 自己在发布文章里就承认,193.6 倍速度和 444.6 倍成本优势可能处在真实收益的高端;测试 workflow 来自自家的 model capabilities team,存在潜在偏差。它还特别说明,一些展示用了短而密集的输入,这会突出其并行采样方式的优势。
这些限定比那个几百倍的数字更值得看。因为它实际上告诉我们 Jev 的优势来自哪里:短上下文、清晰状态、有限输出、高频调用。一旦问题重新变成长上下文、复杂推理或多步因果分析,这本账就必须重算。
所以真正有意思的是:为什么一个 Agent 里的所有自然语言计算,都默认走同一种生成式模型路径?
今天这种默认选择带来的成本,也不只是 token:模型需要稳定输出结构、应用需要解析、异常需要 retry、高风险场景需要 fallback,Prompt 里还会逐渐堆积越来越多行为约束。如果能把一部分局部语义判断从生成环节拆出来,Agent 的工程结构就可能发生变化:
格式与边界:能明确编码的格式问题,继续交给 Regex 和 Schema;
权限与熔断:权限、阈值和状态机,交给代码;
全景推演:需要真正分析和规划的任务,交给 reasoning model;
语义分支:那些规则写不死、却不需要深度推理的语义分支,才轮到低成本 decision model。
三、 Router 能证明有工作,不代表能证明有一个新市场
Jev 最容易理解的用途是 Router。一句用户请求进来,判断下一步应该去 Gmail、Calendar、Web,还是直接回答。这不是新需求,Intent classification 和 semantic routing 已经存在很多年。
但最近有一个信号值得观察。vLLM Semantic Router 目前已经接受了一个 research task,专门评估 Jev 能否作为可选的 remote classifier backend。这个 issue 写得非常克制:它是 evaluation proposal,不是“Jev 已经优于现有 classifier”的声明;维护者接受这项研究,也明确说明这不等于承诺最终 shipping。如果评估结果不好,defer 或 reject 都是完整结果。
这其实正好说明 Jev 当前所处的位置:不是新标准,不是基础设施既成事实,而是一个值得做 A/B test 的新方案。
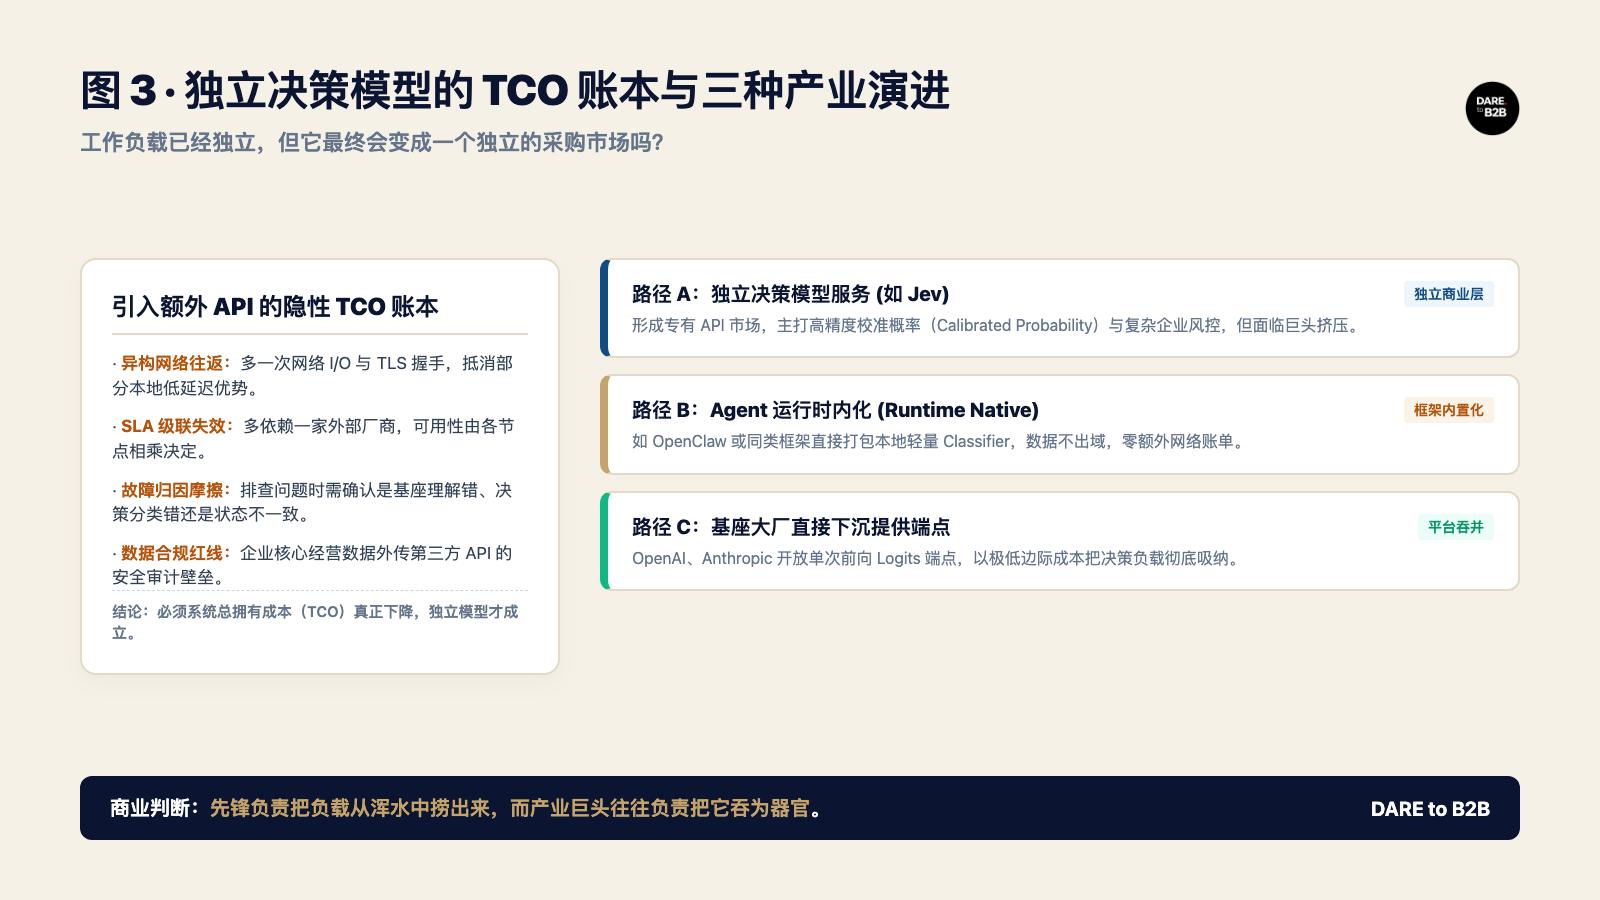
Router 即使跑通,也最多证明 decision workload 有真实工作可以做,它证明不了这一 workload 最终会长成一个独立市场。因为完全可能出现另外几种结果:Agent Runtime 自己内置 classifier、模型厂商提供极低价判断接口、本地小模型已经足够便宜,甚至同一个大模型通过更轻的执行模式就能把差距缩小。
工作负载可以独立,商业层未必独立。
四、Guardrail 真正需要分开的,是语义判断和系统权限
假设 Agent 准备删除整个 Downloads 文件夹。这里至少有两个完全不同的问题:
1.这个动作是不是破坏性操作? 这是语义判断。
2.系统是否允许它直接执行? 这是权限规则。
两者不该混在一起。更合理的结构是:
Semantic judgment: P(destructive) = 0.96
Policy: 超过阈值 → 必须二次确认
模型可以说“这个动作很像高风险操作”。但什么情况下必须确认、谁有权限执行、哪些动作永远禁止自动化,不应该由模型临场发挥,这些必须是代码。
因为 Agent 真正进入企业环境以后,问题就不只是模型聪不聪明,还包括:谁授权?谁确认?谁承担责任?出了错能不能审计?
所以 decision model 真正可能提供的价值,不是“拿到更多控制权”,恰恰相反:它应该只提供判断信号,控制权继续留给确定性系统。
五、 Evaluator 更应该谨慎:能 Assert 的事,别调模型
起初,我最看好的其实是 Evaluator。现在我会把这个判断再收回来一点:如果 Agent 自己说“我完成了”不可信,再加一个模型说“我觉得它真的完成了”,并不会自动解决问题。裁判也会错。
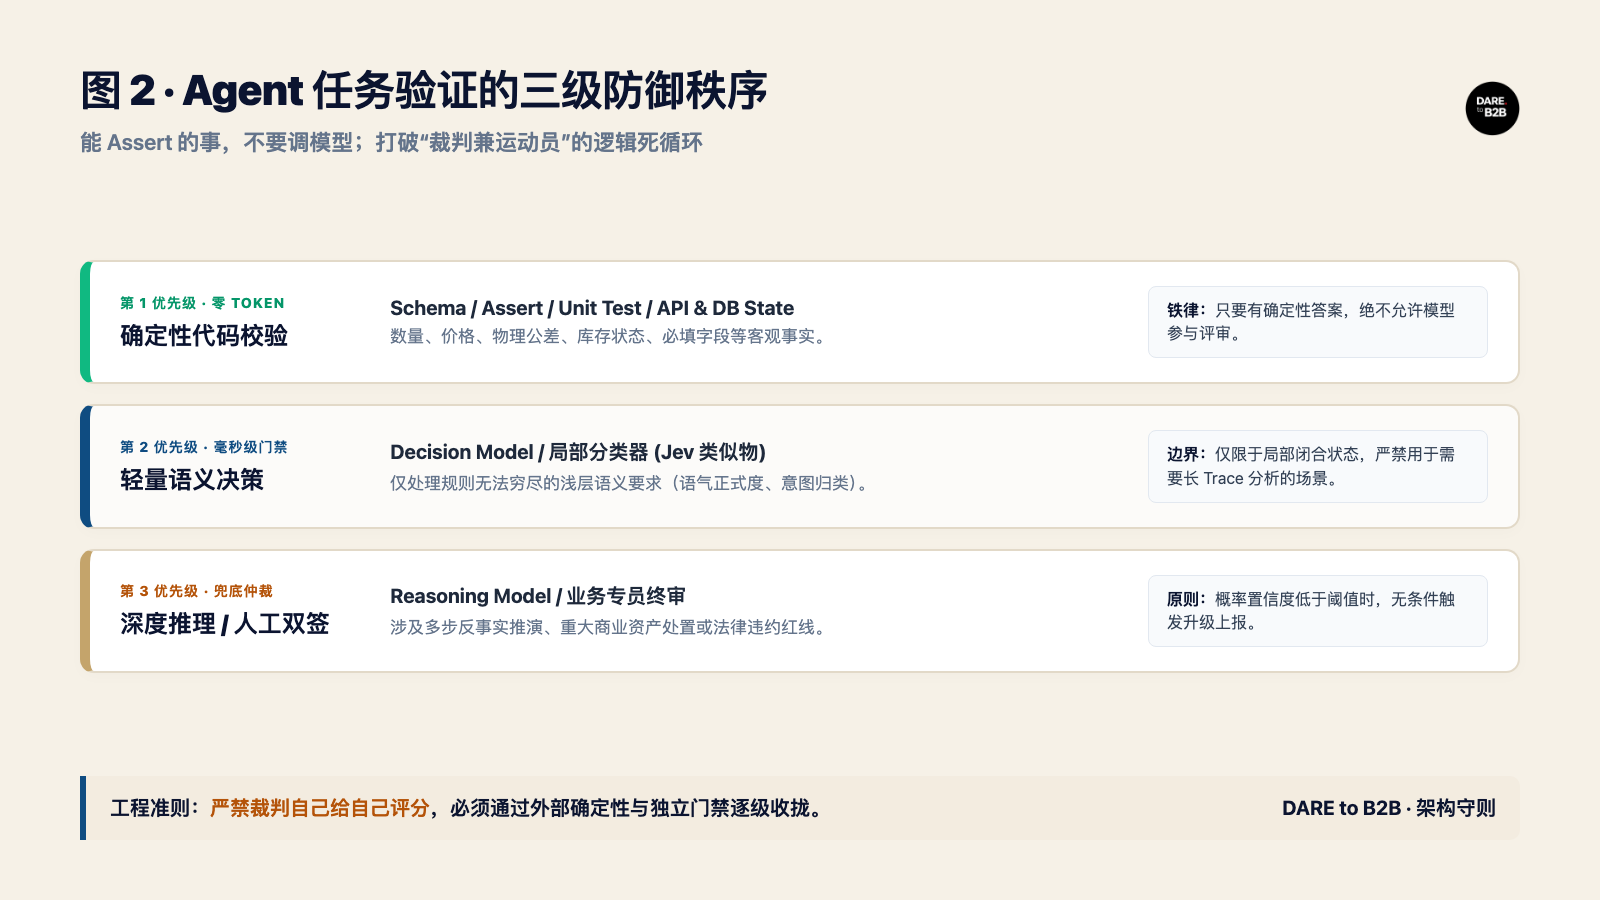
更重要的是,大量任务验证本来就不需要 AI。例如用户要求找 5 家今晚能订位、人均 200 元以内的餐厅:返回了几家?代码数一下;价格有没有超?比较数字;位置是否在指定区域?查结构化地址或地理数据;今晚有没有位?看真实 reservation 状态。
这些事情如果已经有确定性答案,再调用一个概率模型进行“评审”,是在降低可靠性。
图 2 · 验证三级秩序:能 Assert 的事,绝不调用模型
一句工程白话就是:能 Assert 的事,不要调模型。
真正适合 semantic evaluator 的,是剩下那些很难写成布尔表达式的要求。比如:“适合比较正式的商务宴请”、“这封回复有没有真正解决客户最关心的问题”、“答案足够简洁,但不能漏掉关键风险”、“结果是否符合用户表达得很模糊的偏好”。这些才是传统断言难以覆盖的地方。
即便如此,也还存在另一个限制:如果判断必须重新读取完整 Agent trace、理解几十步工具调用,再做复杂因果分析,那么它已经不再是一个浅层局部判断。此时重新交给 reasoning model,可能反而更合理。所以 Jev 在 evaluator 上究竟有多大价值,现在还远没有定论。
六、 独立 Decision Model,也不是免费午餐
还有一本账不能只算 API 单价。假设原来一个 Agent 只依赖一个模型服务,现在为了降低某些判断成本,再接一个独立 decision API。单次判断可能便宜了,但系统多了一种依赖:
多一次网络调用、多一个 SLA、多一种 rate limit、多一套模型版本、多一个 fallback 路径。出现错误以后,也多了一个排查对象:到底是 reasoning model 理解错了?decision model 分类错了?还是两边看到的 state 不一致?
这些都是真实的工程成本。因此真正应该比较的不是 Jev 一次判断多少钱,而是:拆分 decision workload 后,整个 Agent 系统的总拥有成本(TCO)有没有下降。
如果 Agent Runtime 已经可以本地做一个足够好的 classifier,引入额外 SaaS API 可能毫无意义;如果你的业务请求又高度敏感,数据外传甚至可能直接让这条方案出局。所以现在讨论“谁会为 Decision Layer 买单”还太早。先证明 TCO 真能下降,再谈市场。
七、Jev类产品发展走势参照 OpenClaw
OpenClaw 和 Jev 不是同一类产品。OpenClaw 官方今天把 provider、model 和 agent runtime 明确拆成不同层次;其 runtime 负责 agent loop、tool calls 和 turn execution,同时还能在 OpenClaw、Codex、Claude CLI、Copilot 等不同 runtime 之间做选择。
它给我的启发并不是“Jev 会成为下一个 OpenClaw”,更不是“OpenClaw 已经被大厂吞掉,所以 Jev 也一定会”——现在没有证据支持这种确定性的产业故事。
真正值得借鉴的是另一点:Agent stack 并不是一个永远由单个 LLM 包打天下的整体。随着工程成熟,一些职责会被单独命名、单独治理:runtime 是这样,tool policy 是这样,session、workspace、sandbox 也是这样。
decision workload 会不会走同样的路,现在还不知道:它可能成为独立服务,可能成为 runtime 内部的一块能力,也可能被模型厂商做成一个极便宜、开发者几乎感知不到的接口。Jev 的意义,是提前把这个选择题摆到了桌面上。
图 3 · 独立决策模型的 TCO 账本与三种产业演进路径
八、我现在只看三件事
所以,我暂时不会用 GitHub Star 判断 Jev,也不会因为 TypeSafe 的 benchmark 很漂亮,就把它写成 Agent 的下一代基础设施。接下来我只看三件事:
第一,真实 Agent workload 上的总账:
不是只比较 inference 速度,而是一起看准确率、P95 延迟、单位成本、API 失败、fallback、运维和新增依赖。第二,概率到底能不能进入 policy:
TypeSafe 声称 Jev 输出经过 calibration 的概率。现在需要的是第三方和真实业务测试,证明 0.8、0.9、0.95 这些数字在不同数据分布里确实具有稳定意义,而不是只有小数点看起来很精确。
第三,谁最终承接这类 workload:
独立模型公司?Agent Runtime?模型平台?还是本地轻量 classifier?
如果未来 Agent 的默认路径,从“所有自然语言问题 → 一个大模型”,逐渐变成:
能确定计算的 → Code
局部浅层语义判断 → Lightweight Decision
真正复杂的判断 → Reasoning
涉及系统权限的 → Policy
真实世界动作 → Tool
那才说明这里真的发生了架构变化。到那个时候,中间的 Lightweight Decision 最终是不是 Jev,反而是第二个问题。
Jev 现在最值得关注的地方,是它迫使我们重新问一个工程上很朴素的问题:Agent 链路里那些高频、局部、状态闭合的小判断,真的每一次都值得启动完整的 reasoning model 吗?